Los 4 modelos de orquestación de NEO
Esta guía explica, sin necesidad de saber programar, las 4 formas distintas en las que el trabajo de QA automatizado puede arrancar y ejecutarse en este sistema.
Todos los modelos usan las mismas herramientas de base (las "skills": leer una historia, armar un plan de pruebas, explorar la app, generar tests, ejecutarlos, reportar). Lo que cambia entre un modelo y otro es quién decide hacer qué y en qué orden, además de quién se encarga de ejecutarlo.
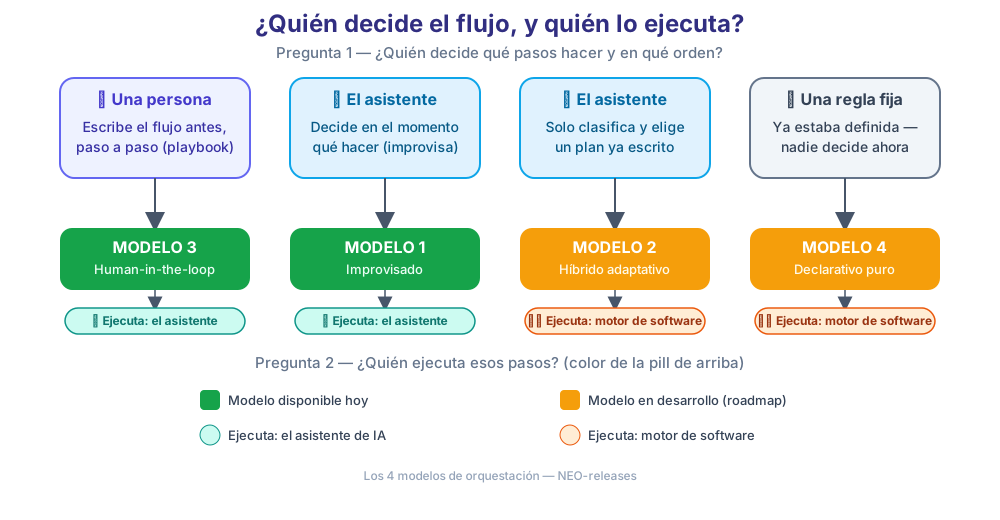
1. Dos preguntas separadas (la clave para entenderlos)
Antes de ver cada modelo, hay que entender que en realidad se están respondiendo dos preguntas distintas:
| Pregunta | Posibles respuestas |
|---|---|
| ¿Quién decide qué pasos hacer y en qué orden? | Una persona · El asistente de IA · Una regla fija ya escrita |
| ¿Quién se encarga de ejecutar esos pasos? | El asistente de IA · Un motor de software (código) que sigue instrucciones al pie de la letra |
Pensalo como pedir comida en un restaurante:
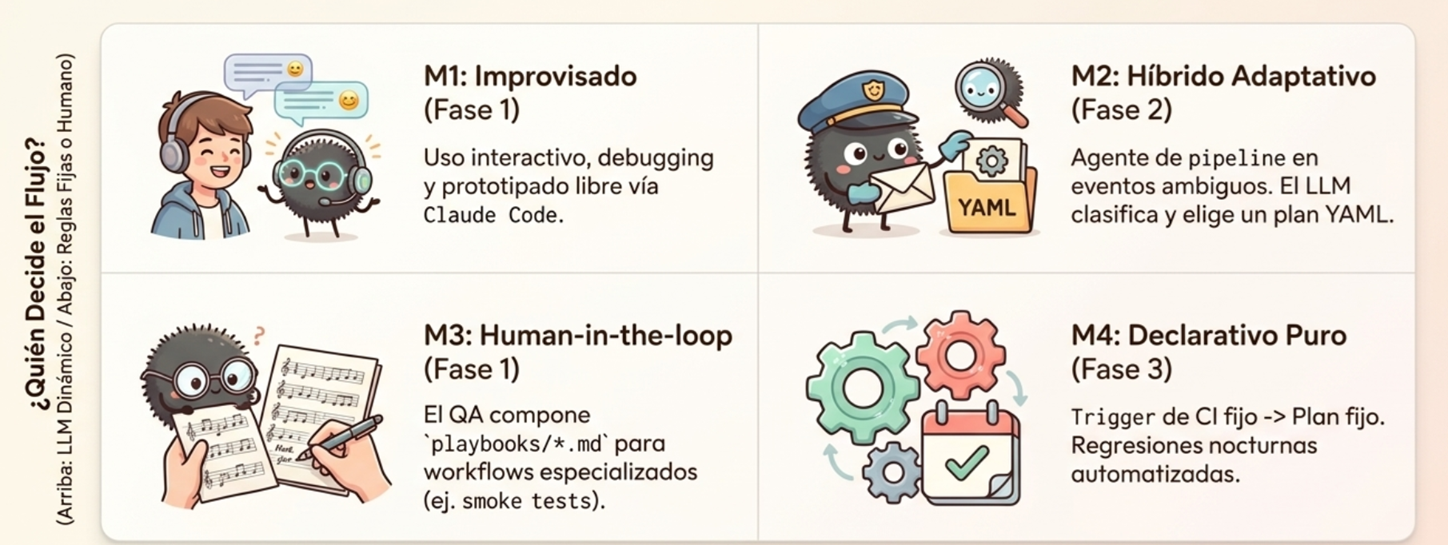
- Un cocinero improvisando con lo que hay en la heladera: él mismo decide el menú y él mismo cocina. Cada vez puede salir distinto. Este representa al modelo 1.
- Un mostrador con protocolos: la persona que te atiende escucha tu pedido y lo deriva al protocolo A o B ya escritos; a partir de ahí, todo sigue esa receta sin inventar nada. Este representa al modelo 2.
- Una receta impresa que alguien sigue a mano: un humano decidió de antemano los pasos, y alguien (o algo) los va tildando uno por uno. Este representa al modelo 3.
- Un semáforo automático: nadie decide nada en el momento — la regla ya está fija de antemano y siempre se aplica igual. Este representa al modelo 4.
2. Tabla resumen de los 4 modelos
| # | Modelo | ¿Quién decide el flujo? | ¿Quién lo ejecuta? | Estado en NEO |
|---|---|---|---|---|
| 1 | Improvisado | El asistente de IA | El asistente de IA | Disponible — es el uso del día a día en tu asistente de IA (Claude Code, Codex o Copilot) |
| 2 | Híbrido adaptativo | El asistente de IA clasifica y elige entre planes ya escritos | Un motor de software (código), no el asistente | Disponible — con el engine, desde la terminal (neo run --input "..."). Ver punto 6 |
| 3 | Human-in-the-loop | Una persona (QA), siguiendo un playbook escrito de antemano | El asistente de IA, dentro de cada paso del playbook | Disponible — son los "playbooks" que ya existen en el proyecto |
| 4 | Declarativo puro | Una regla fija, sin que nadie decida en el momento | Un motor de software (código) | Disponible — con el engine, desde la terminal o el CI (GitLab y GitHub). Ver punto 6 |
¡IMPORTANTE! Los cuatro modelos están disponibles. Los Modelos 1 y 3 se usan desde tu asistente de IA; los Modelos 2 y 4 los ejecuta el engine (
neo), sin asistente abierto. Cómo instalarlo y usarlo: El engine deNEO.
3. Ejemplo guía: "TechStore", una tienda online con carrito de compras
Para que los ejemplos sean concretos, vamos a usar TechStore, una tienda online de electrónica con carrito de compras (agregar productos, ver el carrito, pagar).
3.1 Cómo se ve un test generado (Playwright vs. Lippia)
Sin importar qué modelo dispare el trabajo, el resultado final es siempre el mismo tipo de artefacto: un test automatizado. Lo único que cambia es qué framework lo ejecuta — eso lo define qa-stack.yaml del proyecto (test_framework: playwright o test_framework: lippia), no el modelo de orquestación.
Para el caso "agregar un producto al carrito" (historia US-010), así se ve el mismo caso de prueba en cada framework:
Con Playwright (tests/US-010/tc-01-agregar-producto-carrito.spec.js):
const { test, expect } = require('@playwright/test');

test.describe('US-010 — Agregar producto al carrito', () => {
  test.beforeEach(async ({ page }) => {
    await page.goto('/catalogo');
  });

  test('TC-01 — Agregar un producto disponible al carrito', async ({ page }) => {
    // ACT
    await page.getByRole('link', { name: 'Auriculares Bluetooth XT200' }).click();
    await page.getByRole('button', { name: 'Agregar al carrito' }).click();

    // ASSERT
    await expect(page.locator('[data-testid="cart-count"]')).toHaveText('1');
    await expect(page.locator('.toast-success')).toContainText('Producto agregado al carrito');
  });
});
Con Lippia (features/US-010/tc-01-agregar-producto-carrito.feature + CarritoSteps.java):
# language: es
Feature: US-010 — Agregar producto al carrito

  Background:
    Given el usuario está autenticado en la aplicación

  @US-010 @tc01 @smoke
  Scenario: TC-01 — Agregar un producto disponible al carrito
    Given el usuario está en el catálogo de TechStore
    When agrega el producto "Auriculares Bluetooth XT200" al carrito
    Then el contador del carrito muestra "1" producto
    And se muestra el mensaje "Producto agregado al carrito"
Cuando("^agrega el producto \"([^\"]*)\" al carrito$", (String producto) -> {
    driver.findElement(By.xpath("//a[normalize-space()='" + producto + "']")).click();
    wait.until(ExpectedConditions.elementToBeClickable(BOTON_AGREGAR_CARRITO));
    driver.findElement(BOTON_AGREGAR_CARRITO).click();
});

Entonces("^el contador del carrito muestra \"([^\"]*)\" producto$", (String cantidad) -> {
    wait.until(ExpectedConditions.visibilityOfElementLocated(CONTADOR_CARRITO));
    Assert.assertEquals(driver.findElement(CONTADOR_CARRITO).getText(), cantidad);
});
La diferencia entre frameworks es sintaxis y lenguaje (JavaScript vs. Java/Gherkin, selectores por rol vs. By.xpath/By.id). La diferencia entre modelos (1, 2, 3 o 4) es otra cosa completamente distinta: quién decidió ejecutar este test y en qué momento — no cómo está escrito. Los ejemplos de cada modelo, más abajo, reutilizan este mismo caso de TechStore.
4. Modelos
Modelo 1 — Improvisado
Qué es: le pedís algo al asistente de IA en lenguaje natural (por ejemplo, dentro de Claude Code, Codex o Copilot), y el asistente mismo decide qué herramientas usar y en qué orden, según lo que entendió de tu pedido.
Cuándo usarlo: para el trabajo interactivo del día a día — exploración, prototipos, pedidos puntuales, debugging.
Ejemplo con TechStore:
Le decís al asistente: "Armame los tests para la historia de agregar un producto al carrito."
El asistente, por sí solo, decide leer la historia de usuario, armar un plan de pruebas, explorar la app, generar la suite de tests, ejecutarla y repararla si algo falla, y escribir el reporte final — sin que nadie le haya dicho el orden exacto. Es exactamente lo que hace hoy el playbook completo lippia-neo-meta-run-user-story-e2e cuando se lo invocás directamente. El test que termina generando (en Playwright o en Lippia, según qa-stack.yaml) es el mismo que se muestra en el punto 3.1.
Lo que hay que tener en cuenta: como decide el asistente en el momento, dos ejecuciones sobre el mismo pedido pueden no ser 100% idénticas — puede tomar un camino levemente distinto cada vez. Por eso no se recomienda para procesos donde se necesita que el resultado sea siempre reproducible (por ejemplo, un pipeline automático de CI/CD).
Modelo 2 — Híbrido adaptativo
Qué es: el asistente de IA no improvisa el flujo entero, solo clasifica el pedido y elige, entre una lista cerrada de "planes" ya escritos de antemano, cuál corresponde. A partir de ahí, un motor de software (no el asistente) ejecuta ese plan paso a paso, siempre de la misma forma.
Cuándo se usaría: en un pipeline automático, cuando llega un evento ambiguo que necesita algo de criterio para saber a qué plan corresponde. Por ejemplo, alguien deja un comentario en un Merge Request pidiendo algo en lenguaje libre.
Ejemplo con TechStore:
Alguien comenta en un Merge Request de TechStore: "volvé a probar el flujo de pago, algo cambió ahí."
El "clasificador" entiende que ese pedido corresponde al plan regression-payment (ya escrito de antemano) y se lo pasa al motor, que lo ejecuta exactamente igual que la última vez que se ejecutó ese plan — sin inventar nada nuevo en el camino. El motor genera y ejecuta el mismo tipo de test del punto 3.1 (Playwright, Cypress o Lippia, según qa-stack.yaml del proyecto) — lo que cambia frente al Modelo 1 es que nadie improvisó el flujo: el clasificador solo eligió qué plan ya escrito correspondía.
Disponible hoy: sí, con el engine: neo run --input "<pedido>" --plans-dir plans. Si el clasificador no está seguro (confianza menor a 0,7), no ejecuta nada y escala a una persona. Cómo funciona por dentro: Modelos de orquestación en el engine.
Modelo 3 — Human-in-the-loop (con playbooks)
Qué es: una persona (de QA) decide el flujo de antemano y lo deja escrito en un documento paso a paso (un "playbook"). El asistente de IA no decide el orden — solo ejecuta lo que dice cada paso del playbook, con su propio criterio dentro de ese paso puntual.
Cuándo usarlo: para workflows especializados que se repiten seguido y conviene que salgan siempre igual: puesta en marcha de un proyecto nuevo, smoke test después de un deploy, una exploración amplia de la aplicación, una demo para el cliente.
Ejemplo con TechStore:
Alguien del equipo de QA sigue el playbook
new-project-bootstrap.mdpara dejar TechStore configurado: primero el asistente detecta con qué está armado el proyecto, después arma el pipeline de CI, y por último ejecuta una prueba piloto — siempre en ese orden, porque así lo define el playbook, no porque el asistente lo decidió en el momento.
Si el playbook usado fuera feature-new-end-to-end.md sobre la historia del carrito, el paso "generar suite" produciría el mismo test del punto 3.1 (Playwright, Cypress o Lippia) — la diferencia frente al Modelo 1 no está en el test generado, sino en que acá el orden de los pasos ya estaba escrito de antemano.
Disponible hoy: sí — son los playbooks que ya existen en la carpeta playbooks/ del repositorio (por ejemplo new-project-bootstrap.md, smoke-test-post-deploy.md, exploratory-testing-portfolio.md, demo-walkthrough.md, bug-fix-cycle.md). Las guías de esta misma documentación (los "instructivos") están escritas justamente para acompañarte a usar estos playbooks.
Modelo 4 — Declarativo puro
Qué es: una regla que se escribe una sola vez, de antemano, y que después se cumple siempre igual, automáticamente, cada vez que pasa algo puntual. Nadie tiene que decidir nada en el momento — ni una persona ni el asistente de IA — porque la decisión ya quedó tomada desde antes. Es el modelo más estricto y más previsible de los cuatro: siempre hace exactamente lo mismo, sin variaciones.
Cuándo se usaría: cuando hay un proceso automático (un pipeline de CI/CD) que necesita reaccionar solo, sin que nadie intervenga, ante algo que pasa técnicamente. Por ejemplo: "cada vez que se sube código nuevo, ejecutar las pruebas básicas" o "todas las noches, a las 2am, ejecutar las pruebas completas".
Ejemplo con TechStore:
Cada vez que alguien sube un cambio de código a la versión principal de TechStore, se dispara solo — sin que nadie lo pida — el plan de pruebas básicas (
qa-smoke). Y todas las noches, a una hora fija, se dispara solo el plan de pruebas completas.
Disponible hoy: sí. Es el modelo que usan los pipelines que genera lippia-neo-ci-bootstrap: un MR/PR con el label feature dispara el plan feature-new-end-to-end. GitLab y GitHub están soportados de punta a punta; Bitbucket se dispara a mano. Ver El engine de NEO y Configurar el CI.
5. ¿Cuál es el modelo que debo usar hoy en la práctica?
| Situación | Modelo a usar hoy |
|---|---|
| Quiero pedirle algo puntual a mi asistente de IA (Claude Code, Codex o Copilot), sin seguir una receta fija | Modelo 1 — simplemente pedíselo en lenguaje natural |
| Necesito hacer algo que se repite seguido (bootstrap de proyecto, smoke test post-deploy, regresión de un módulo, demo) y quiero que salga siempre igual | Modelo 3 — buscá el playbook correspondiente en playbooks/ y seguilo paso a paso |
| Quiero que un pedido en texto libre se derive automáticamente al plan correcto | Modelo 2 — neo run --input "<pedido>" (ver El engine) |
| Quiero que un MR/PR, un push o un horario dispare pruebas automáticas sin que nadie las pida | Modelo 4 — un plan del engine disparado por el CI (ver Configurar el CI) |
6. Los Modelos 2 y 4 y el engine
Los cuatro modelos usan las mismas skills de base. La diferencia es que los Modelos 2 y 4 necesitan además un motor (engine) de software que ejecute planes ya escritos de forma reproducible, sin usar el criterio del asistente de IA para decidir la coreografía. Ese motor es neo, del repositorio crowdar-engine-mvp.
| Etapa | Qué habilita | Estado |
|---|---|---|
| Fase 2 — Motor (engine) propio | Modelo 2 (híbrido adaptativo) y Modelo 4 desde la terminal | Disponible |
| Fase 3 — Integración con CI/CD | Modelo 4 disparado por el pipeline | Disponible en GitLab y GitHub. Bitbucket se dispara a mano; Jenkins no está soportado |
Todo el detalle (requisitos, comandos, formato de los planes y patrones de composición) está en la sección El engine de NEO.
7. Resumen visual comparativo
8. Problemas comunes (y qué hacer)
| Lo que ves | Por qué puede pasar | Qué hacer |
|---|---|---|
| Le pedís al asistente algo puntual y dos ejecuciones sobre el mismo pedido no dan exactamente el mismo resultado | Estás usando el Modelo 1, que por diseño improvisa el flujo cada vez | Si necesitás que el resultado sea siempre igual, usá un playbook (Modelo 3) en vez de un pedido libre |
| Alguien te pide "que se ejecute solo cada vez que se sube código" | Eso corresponde al Modelo 4 | Configurá el pipeline con lippia-neo-ci-bootstrap (ver Configurar el CI) |
| Buscás un "clasificador automático" que elija el plan según un pedido ambiguo | Eso corresponde al Modelo 2 | Usá neo run --input "<pedido>" (ver El engine) |
El Modelo 2 responde escalated to human |
El clasificador no estuvo seguro (confianza menor a 0,7) o el pedido no traía los datos que necesita el plan | Reformulá el pedido con más detalle, o ejecutá el plan directo con el Modelo 4 |
No encontrás el playbook que necesitás en playbooks/ |
Puede que ese workflow específico todavía no tenga un playbook escrito | Usá el Modelo 1 (pedido puntual al asistente) mientras se escribe el playbook correspondiente |
9. Requisito técnico de CI para Playwright (Modelos 2 y 4)
Cuando el pipeline de CI/CD (Modelo 2 y 4) se ejecuta sobre un proyecto configurado con test_framework: playwright, el motor necesita encontrar el navegador exactamente donde lo instaló — si no, el paso de exploración de la app falla con un error del tipo "no se encuentran los binarios del browser", aunque los tests del propio proyecto sí ejecuten bien.
Por qué pasa: el motor (engine) trae su propio navegador ya instalado adentro de la imagen, para poder "explorar la app" (punto 1 de esta guía) sin depender de lo que tenga el proyecto. Cuando el proyecto también es Playwright, ese navegador del motor tiene que compartir carpeta con el que instala el propio proyecto — y si el pipeline no le indica explícitamente al motor en qué carpeta buscar, cada uno termina mirando un lugar distinto y no se encuentran. Cuando el proyecto no es Playwright (pytest, lippia), este problema no existe: el motor usa su navegador de fábrica sin que nadie lo toque.
Qué hacer: esto ya está resuelto en los templates de CI que genera la skill lippia-neo-ci-bootstrap para GitLab, GitHub y Bitbucket — la variable que fija esa carpeta compartida se activa solo cuando test_framework: playwright, nunca para los demás frameworks. Si armás un pipeline a mano en vez de generarlo con la skill, replicá esa misma condición.